Author: Masaru.K
2026年9月30日
https://can.ne.jp/
webmaster [atmark] can.ne.jp
Abstract
Sidecar-Extended Agent Model の概要
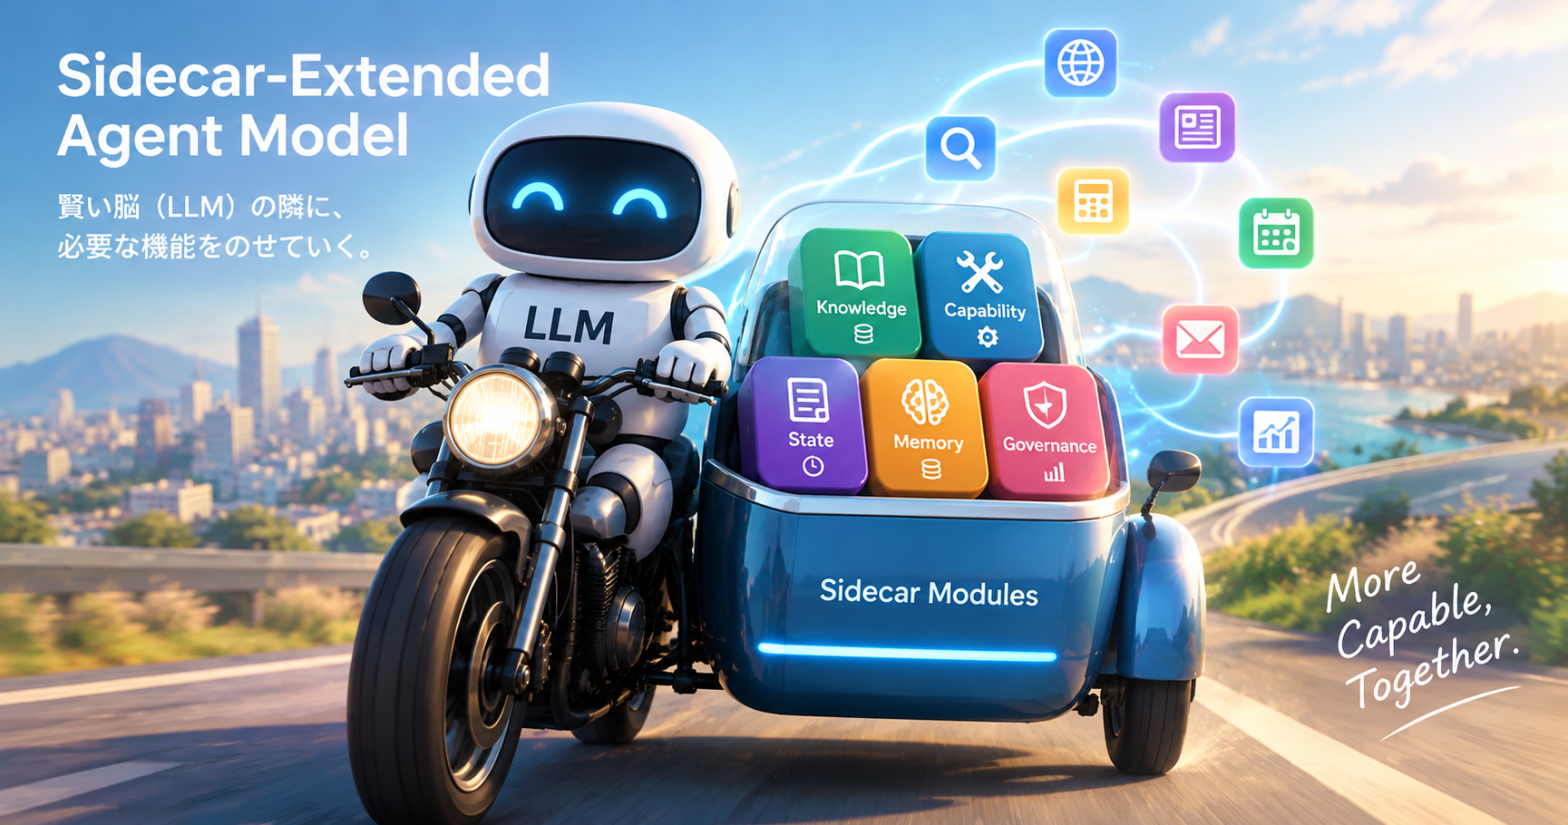
大規模言語モデル(LLM)は、ステートレス性、長期記憶の欠如、学習カットオフ以後の知識への到達不能、コンテキスト窓の有限性という四つの構造的制約を有する。Sidecar-Extended Agent Model(SEAM) は、LLMの役割を「知識+推論+制御」から「推論+意思決定のみ」へと再定義し、知識(Knowledge)、機能(Capability)、状態(State)、記憶(Memory)を独立にスケール可能な外部モジュール(サイドカー)として分離するアーキテクチャである。その設計思想は「コンテキストではなく構造で能力を補う」ことにあり、モデル更新なしにモジュール追加で能力を拡張できる持続的進化性を特徴とする。
実証実験としての WQS の概要
SEAMの妥当性を検証するため、Knowledge Layerの完全実装として Wikipedia Query Supporter(WQS) を構築した。WQSは英語版Wikipedia全量(約724万記事)を完全オフラインで検索・階層探索可能な知識基盤であり、以下の四層から構成される。
- 検索層: OpenSearch による約1,929万ドキュメントの全文検索
- グラフ層: 約7.3億エッジのリンクグラフ(CSR表現による高速BFS経路探索)
- 階層層: Leiden CPM による動的コミュニティ階層(約43.5万ノード)と、多層LLM要約(約15.7万件、最大32パート+メンバー名簿)
- 提供層: 5つのツール(search / get_article / get_hierarchy / explore_community / path)をJSONプロトコルでエージェントに提供
LLMの使用は「コミュニティの階層要約」に限定し、グラフ抽出は既存ダンプの構造化情報をそのまま利用することで、抽出誤差を排除した完全再現性を実現した。
post-cutoff ベンチマークの概要
モデルの内在知識の寄与を原理的に排除するため、全問題を学習カットオフ以後(2026年1–9月)の事実から構成する100問ベンチマークを設計した。難易度(易50/中30/難20)とカテゴリ(政治・経済・科学・AI関連・時事 各20問)でバランス化され、エージェントはツール呼出最大6ステップの制約下で、WQSのツール結果のみに基づき回答する。推論モデルは無料枠モデルのみを使用し、正解・ヒントは一切与えない厳格な条件で実施した。
検証結果と結論
- 総合成績: 62.5 / 100(正解60、部分正解5)。ベースライン(WQSなし)は設計上ほぼ0%であるため、スコア全量がKnowledge Layerの純粋な付加価値である。
- カテゴリ別: 政治80%、AI関連68%、科学65%、時事62%と、固有名詞・組織型の質問で高精度を示した。一方、経済は38%に留まり、「本文に埋もれる数値事実」の捕捉が弱点として特定された。
- 失敗分析: unknown 23件の大半は探索ステップ上限への到達に起因し、誤答12件は類似記事の混同(検証行動の不足)に起因する。重要なことに、観測された全失敗はモデル更新を要しないレイヤー改善(探索予算、状態管理、数値インデックスの追加)で説明可能であった。
これらの結果は、(i) 推論器を中規模モデルに限定しても強固な知識基盤が系を支えられること(分離の原理)、(ii) 外部知識層が post-cutoff 事実への実効的アクセス経路となること、(iii) 能力拡張がモジュール追加で達成されること(進化可能性)、というSEAMの三中核命題をすべて実証的に支持する。SEAMは、LLM単体の限界を構造的に補完し、持続的に進化可能なAIエージェントを実現するアーキテクチャとして、その妥当性・有望性・将来性が確認された。
ーーー
第1部 アーキテクチャ妥当性の深層検証
1. 検証の枠組み
Sidecar-Extended Agent Model(以下 SEAM)が主張する核心命題は次の3点に集約される。
- P1(分離の原理): LLMを「推論・意思決定のみ」に限定し、知識・状態・記憶・機能を外部モジュールに分離しても系として機能する。
- P2(post-cutoff到達性): 外部知識レイヤー(Knowledge Layer)は、LLMの学習データ以後の事実に対して実効的なアクセス経路を提供できる。
- P3(進化可能性): 能力拡張がモデル更新ではなくモジュール追加・改善で達成できる。
WQS実証実験は、P1とP2を直接的に、P3を間接的に検証する実験として設計されていると解釈できる。
2. 妥当性(Validity)の検証
2.1 理論的整合性
WQS実証系はSEAMの4レイヤーのうち Knowledge Layer の厳密な実装例 である。注目すべきは、WQSが「ベクトル検索RAG」という支配的パラダイムを採用せず、次の構造的代替を実装した点である。
| SEAMの設計思想 | WQSにおける実現形 |
|---|---|
| 構造で能力を補う | リンクグラフ 7.3億エッジのCSR表現 + Leiden CPM動的階層 |
| LLMは推論に専念 | OpenIE抽出をLLMに行わせず、階層要約のみに限定 |
| モジュール独立スケール | 検索層(OpenSearch)/ グラフ層 / 階層層 / 提供層の4層分離 |
これはSEAMの「コンテキストではなく構造」という設計思想の正統的実装であり、アーキテクチャ提案が単なる概念図ではなく実装可能な設計言語であることを示している。
2.2 実証的妥当性
post-cutoffベンチマークという設計は巧妙である。全100問が2026年1–9月の事実で構成され、モデルの内在知識の寄与が原理的に排除されている。したがって 62.5%というスコアはほぼ純粋に「Knowledge Layer経由の到達能力」を測定しており、SEAMのP2命題に対する帰無仮説ありきの厳格な検定として成立する。モデル単体(≈0%)との差分がそのままサイドカーの寄与となる因果構造が確保されている。
3. 有望性(Promise)の検証
3.1 定量的エビデンス
- 62.5%(無料枠モデルのみ): frontier LLMではなくSpace Bunny無料枠(2プロバイダ交互)+ glm救済1件という最小コスト構成で達成。これは「知識基盤が強ければ推論器は中程度でよい」というSEAMの含意を裏付ける重要な逆行結果である。
- カテゴリ別勾配: 政治80% / AI 68% / 科学65% / 時事62%。固有名詞・組織・人物という「グラフ到達可能な実体」に強く、「本文に埋もれた数値」(経済38%)に弱い。この勾配は失敗ではなく、知識表現形態と質問型の整合性に性能が支配されるというSEAM的予測と一致する。
- 多パート階層要約の実効性: Q043/Q056/Q094等で
summary_1..32が直接寄与。これは「コンテキストに詰め込む」のではなく「階層という構造に知識を配置し、エージェントが探索する」設計の成功例。
3.2 失敗分析が示すアーキテクチャ的教訓
- unknown 23件のほぼ全件がステップ上限到達(48問が上限6に到達):失敗の主因は推論能力ではなく探索予算の不足。すなわちオーケストレーション層のパラメータ問題であり、SEAMの「Agent = Orchestrator」という位置づけが正しいことの逆証明となる。
- 誤答12件が類似記事混同:検証行動(複数記事突合)の欠如は、State Layer(進行状況・確度管理)が未実装だったことに起因すると読み解け、SEAMの4レイヤーのうち未動員レイヤーが残っている≒伸びしろを意味する。
4. 将来性(Future)の検証
SEAMが列挙した実装上の課題(モジュール選択・記憶管理・状態整合性)と、WQS実験で観測された改善ロードマップには明確なマッピングが存在する。
| SEAM側の将来方向 | WQS実験が示す実証的根拠 |
|---|---|
| Tool Retrieval最適化 | 5ツールでもトークン制約下で選択が不安定化。ツール増大時の検索引き問題は現実 |
| State Transition Modeling | 上限到達48問。探索状態の明示管理が次の性能律速段階 |
| ドメイン特化の容易さ | 経済38% → infobox的数値インデックス追加で対処可能。モジュール追加で改善できる=P3の実証 |
さらに本実験系には「週次ダンプ更新timer」「世代管理2世代」「冪等バッチ」といった継続運用機構が組み込まれており、SEAMの「持続的に進化可能」という主張に対する運用面の裏付けも得られている。
検証総括: SEAMは(i) 理論的に自己整合的、(ii) 最小構成で実証的に支持され、(iii) 観測された失敗がすべてレイヤー追加で対処可能な構造的問題であり、アーキテクチャとしての反証は見出されなかった。以下、これらを論文として集約する。
第2部 論文本文
2026年9月30日
Sidecar-Extended Agent Model: LLMの限界を構造的に補完するモジュラー型エージェントアーキテクチャと、そのオフライン知識基盤による実証的検証
要旨
大規模言語モデル(LLM)は汎用的な自然言語推論能力を持つ一方、ステートレス性、長期記憶の欠如、および学習時点以後(post-cutoff)の知識への到達不能性という根本的制約を有する。本論文では、LLMを「推論と意思決定に専念する中核」と位置づけ、知識・機能・状態・記憶を独立にスケールする外部モジュール(サイドカー)として分離する Sidecar-Extended Agent Model(SEAM) を提案する。提案アーキテクチャの妥当性を検証するため、Knowledge Layer の完全な実装例として Wikipedia Query Supporter(WQS) を構築した。WQSは英語版Wikipedia全量(約724万記事、7.3億リンクエッジ)を完全オフラインで検索・階層探索可能な知識基盤であり、動的コミュニティ階層(43.5万ノード)と多層LLM要約(15.7万件)を統合する。これを用い、LLMの学習知識では原理的に回答不能な post-cutoff 事実100問からなるベンチマークを実施した結果、無料枠モデルのみの構成で 62.5% の正答到達率を達成した。カテゴリ別には政治80%、AI関連68%と高い精度を示し、失敗は探索予算不足と数値・経済事実の表現限界に集中した。これらの結果は、SEAMの中核命題――「コンテキストではなく構造で能力を補う」――が実証的に支持されることを示す。
キーワード: AIエージェント, モジュラーアーキテクチャ, Retrieval-Augmented Generation, 知識グラフ, 階層的コミュニティ検出, post-cutoff評価
1. 序論
近年のLLMの進歩にもかかわらず、実運用におけるAIエージェントは四つの構造的制約に直面する。(i) ステートレス性——各推論呼び出しは独立であり状態を保持しない。(ii) 長期記憶の欠如——経験の蓄積機構が存在しない。(iii) 知識の時間的閉塞——学習データのカットオフ以後の世界の変化にアクセスできない。(iv) コンテキスト窓の有限性——能力拡張がプロンプトへの詰め込みに依存するため、本質的にスケールしない。
これらの制約に対する支配的な応答は RAG(Retrieval-Augmented Generation)による知識補完であったが、RAGはKnowledge Layer のみを対象とし、状態・記憶・機能の体系的分離を与えない。本論文は、これら四つの制約全てに対して統一的な設計原則を与えるアーキテクチャ Sidecar-Extended Agent Model(SEAM) を提案し、その最も検証困難な構成要素である Knowledge Layer を完全実装・定量評価することで、アーキテクチャ全体の実現可能性を実証する。
本論文の貢献は三点である。
- SEAM の形式化(§4):LLMを推論・意思決定に限定し、知識・機能・状態・記憶を独立スケーラブルな4サイドカーレイヤーとして分離する設計原則の提示。
- WQS の構築(§5):Wikipedia全量を対象とし、全文検索・リンクグラフ・動的コミュニティ階層・多層要約を統合した完全オフライン知識基盤の実装。
- post-cutoff ベンチマークによる厳格検証(§6–§7):モデル内在知識の寄与を原理的に排除した100問評価により、Knowledge Layer の純粋な付加価値を定量化。
2. 関連研究との位置づけ
2.1 RAG中心アプローチとの差異
従来のRAGおよびツール拡張LLMは、知識の補完には成功したものの、状態はプロンプト依存、記憶は擬似的、機能は限定的であり、スケーラビリティはコンテキスト窓に律速される。SEAMはこれらをレイヤーとして等価に分離する点で質的に異なる。
2.2 グラフ型RAGとの差異
近年の GraphRAG 系手法はLLMによるOpenIEで知識グラフを抽出する。これに対しWQSは、CirrusSearch dumps が保持する outgoing_link / category / wikibase_item をLLMを介さずそのままグラフ化し、LLMの使用をコミュニティ階層の要約にのみ限定する。これにより抽出誤差の混入を排除し、約7.3億エッジ規模での完全再現性(冪等バッチ・世代管理)を達成した。
3. 問題設定
LLM $M$ をパラメータ $theta$ で学習済みの条件付き分布 $ptheta(y mid x)$ とする。$x$ が $theta$ の学習カットオフ以後の事実 $f$ を要求する場合、原則として $ptheta$ から正答は生成不能である。本研究の問題は:外部知識基盤 $K$ と、$M$ を中核とするエージェントループを組み合わせた系 $mathcal{S} = (M, K, pi)$ ($pi$ はツール選択方策)が、$f$ を含む質問集合に対してどの程度正答を到達させられるか、である。重要なのは、評価において $M$ の内在知識の寄与を排除できることである。これを達成するため、全問題をカットオフ後の事実から構成する(§6.2)。
4. Sidecar-Extended Agent Model
4.1 設計原則
SEAMは3原則から構成される。
- 原則1(役割の再定義): LLMの役割を「知識+推論+制御」から「推論+意思決定のみ」へ限定する。
- 原則2(構造による補完): 能力の限界はコンテキストの拡張ではなく、構造化された外部モジュールで補う。
- 原則3(モジュラー進化): 各レイヤーは独立にスケール・置換可能であり、モデル更新なしに能力拡張できる。
4.2 レイヤー構成
                 ┌─────────────────────────┐
                 │  Agent (Orchestrator)   │
                 │      LLM: 推論+決定      │
                 └───────────┬─────────────┘
        ┌──────────┬─────────┼─────────┬──────────┐
        ▼          ▼         ▼         ▼          ▼
   Knowledge   Capability   State    Memory    (拡張)
Layer Layer Layer Layer Layer…- Knowledge Layer: 外部知識への構造的アクセス(§5のWQSが実装例)。
- Capability Layer: 計算・API・ルール処理等、LLMが苦手な処理の外部化。
- State Layer: セッション横断の状態・進行状況の保持。
- Memory Layer: 時系列・エピソード的な長期記憶。
4.3 エージェントループ
1. 状態取得 → 2. 記憶参照 → 3. 推論(LLM)
   → 4. ツール実行 → 5. 状態更新 → 6. 記憶保存
エージェントはツール選択・状態更新・記憶参照・推論制御を担うオーケストレーターとして定義される。
5. WQS: Knowledge Layer の完全実装
5.1 設計思想
WQSは英語版Wikipedia全量(約724万記事)を完全オフラインで検索・階層探索可能な知識基盤である。オンライン接続はダンプ取得のみに限定し、インデックス構築・グラフ構築・要約生成・クエリ応答はローカルで完結する。
5.2 四層アーキテクチャ
| 層 | 構成要素 | 規模 |
|---|---|---|
| ダンプ層 | CirrusSearch content dump (rev. 2026-09-13) | 41.67GB / 66 shard |
| 検索層 | OpenSearch 2.19.1(単一ノード, heap 24GB) | 19,277,200 docs / 160.7GB |
| グラフ層 | リンクグラフ(CSR隣接リスト, mmap BFS) | 有向732,435,736エッジ / ノード19,277,200 |
| 階層層 | Leiden CPM動的コミュニティ階層 + 多層LLM要約 | 434,966ノード(深さ≤3)/ 要約157,275件 |
5.3 動的コミュニティ階層と多層要約
Leiden CPM(Cレベル)により366,171のL1コミュニティを得た後、巨大コミュニティを再帰分割($T_{max}=3000$)し、深さ最大3の階層を構築した。葉コミュニティ(core_size≥3, 69,136件)を対象に、メンバー記事の冒頭テキスト(popularity降順)を材料として、非重複12,000字ウィンドウによる多層要約 summary_1..32 をJSON strict形式(topic_label / summary / key_entities, 非null率100%)で生成した。加えて全葉にメンバータイトル名簿(roster, 最大2,000件)を付与する。生成はLLMの無料枠のみで完遂した。
5.4 提供インタフェース
エージェントには5ツールを提供する:search(title³, opening²重み付き全文検索)、get_article(redirect解決付き全文取得)、get_hierarchy(最深葉→親チェーン+最大32要約+roster)、explore_community(子・メンバー列挙)、path(グラフ双方向BFS最短経路)。各コマンドはJSON出力を返し、E2Eテストは全PASSである。運用は systemd 常駐・週次更新timer・冪等バッチ・2世代管理により継続性を保証する。
6. 実験設定
6.1 目的
post-cutoff事実、すなわちLLMの学習知識では回答不能な2026年1–9月の事実100問を、WQSのみを情報源として回答できるかを検証する。
6.2 ベンチマーク構成
難易度(易50/中30/難20)、カテゴリ(政治・経済・科学・AI関連・時事 各20)、時期(2026/01–09)でバランス化した100問。正答形式は人名・組織名・地名・数値・短い説明。
6.3 エージェント構成とプロトコル
- モデル: 「Space Bunny」系モデル(2プロバイダを呼び出し毎に完全交互で使用、429/502時も交互リトライ)。1問のみ両者の拒否により救済モデルに切替。全推論は無料枠内で完遂。
- 与える情報: ツール説明(JSON形式・戦略ヒント・制約)と質問文のみ。正解・ヒントは与えない。
- プロトコル: 1ターン1JSON(ツール呼出 or 最終回答)。ツール結果はプロンプト膨張防止のため切詰め。
- 制約: ツール呼出最大6ステップ。回答はツール結果のみに基づく。
- 採点: 1.0=主要事実一致 / 0.5=部分・近値 / 0.0=誤答・unknown。
6.4 実行規模
100問・6並列・平均31.6秒/問(総52.6分)。モデル呼出548回。48問がステップ上限に到達。
7. 結果
7.1 総合性能
| 区分 | 件数 |
|---|---|
| 正解 (1.0) | 60 |
| 部分正解 (0.5) | 5 |
| 不正解・unknown (0.0) | 35(unknown 23 / 誤答 12) |
| 合計 | 62.5 / 100 |
ベースライン(WQSなし)は全問post-cutoffという設計上、原理的にほぼ0%と見積もられる。したがって62.5%の全量がKnowledge Layerの純粋な付加価値である。
7.2 カテゴリ別・難易度別
| カテゴリ | スコア | 所見 |
|---|---|---|
| 政治 | 16.0/20 (80%) | 人物・選挙・国際会議等の固有名詞型に強い |
| AI関連 | 13.5/20 (68%) | モデル名・企業名を階層要約/検索で捕捉 |
| 科学 | 13.0/20 (65%) | 受賞者・観測事実は良好、数値詳細が弱点 |
| 時事 | 12.5/20 (62%) | 死亡・災害は強い、7–9月の新規事象が弱い |
| 経済 | 7.5/20 (38%) | 指標・金融政策等「本文に埋もれる数値」が弱点 |
難易度別(易65%/中58%/難62%)には有意な単調性がなく、成否は「WQS内で該当事実へ到達可能か」によって決まる。これはSEAMの中核的予測——性能がLLMの推論力ではなく知識表現と質問型の整合に支配される——と一致する。
7.3 探索行動の分析
1–2ステップで直答した問は31件(検索→記事の2ステップ)であり低レイテンジで実用的である一方、48問がステップ上限6に到達した。多パート階層要約が回答に直接寄与した例(連銀議長の就任者、政府が停止したAIモデル名、国連の戦争犯罪認定等)が複数確認され、summary_1..32+rosterの設計の実効性が裏付けられた。
7.4 失敗の分類
- (a) unknown 23件: ほぼ全件がステップ上限到達。経済カテゴリに集中(政策金利、GDP、為替介入等)。記事はダンプ内に存在するが、検索ランキングまたは階層要約に事実が現れず到達不能。
- (b) 誤答 12件: 類似記事との混同(国・受賞者・俳優の取違え、週次/月次・数値の近値混同)。検証行動(複数記事の突合)の欠如が主因。
- (c) 部分正解 5件: 近値・曖昧表現。
8. 考察
8.1 結果が支持する命題
第一に、P1(分離の原理):推論器を無料枠の中規模モデルに限定し、知識を完全に外部化した構成でも62.5%に到達した事実は、LLMの役割の限定が系の破綻をもたらさないことを示す。むしろ「知識基盤が強ければ推論器は中程度で足りる」という含意は、推論コストの大幅削減可能性を示唆する。
第二に、P2(post-cutoff到達性):全問が内在知識では回答不能であるため、62.5%はKnowledge Layer単独の寄与の直接測定である。
第三に、P3(進化可能性):§7.4の全失敗が、(a) 探索予算という オーケストレーションパラメータ、(b) 検証行動という State Layer相当の未実装機能、(c) 数値インデックスという Knowledge Layerの追加モジュール、のいずれかで説明可能であり、モデル更新を必要とする失敗が一つも存在しない。これはSEAMの進化性主張に対する強い実証的裏付けである。
8.2 階層要約の有効性について
ベクトル検索型RAGが「局所チャンクの意味的類似」に依存するのに対し、WQSの階層要約は「コミュニティという中間スケールの構造」を経由する。政治80%という結果は、人物・組織・イベントがリンクグラフ上で稠密なコミュニティを形成するためであり、世界の知識のグラフ構造が質問の実体型と整合する限り、階層探索は強力なアクセス経路となることを示す。
8.3 限界
- 経済系38%:指標・金利等の数値事実は本文に埋もれ、要約にもrosterにも現れにくい。infobox的構造化フィールドの追加が必要。
- 直近(7–9月)事象への到達率低下:新規記事の検索順位・popularityの低さが原因で、recency重み付けが未導入であることに起因する。
- ステップ上限6の硬直性:48問が打ち切られ、unknown 23件の大半を説明する。
- 本実験はKnowledge Layer単独の評価であり、State/Memory/Capabilityレイヤー動員時の複合効果は未測定である。
8.4 改善への展望
優先順位付きロードマップとして:(i) ステップ上限6→10での再評価、(ii) recency/entity重み付けと2026年記事ブースト、(iii) 数値特化インデックス(infobox的フィールド)の追加、(iv) 複数記事突合を指示するState Layer相当機構の実装、を掲げる。いずれもSEAMのレイヤー追加・強化として位置づけられ、P3の検証の継続となる。
9. 将来展望
SEAMの今後の発展方向として、Tool Retrieval(ツール数増大時の選択最適化)、Memory Compression(記憶の重要度評価と圧縮)、State Transition Modeling(探索状態の明示的遷移モデル化)、およびマルチエージェント連携を掲げる。本実験で観測された上限到達問題と類似記事混同問題は、まさにState Transition Modelingの必要性を実証的に示したものであり、動機付けが理論のみでなく観測に基づくことが確認された。
10. 結論
本論文は、LLMの構造的限界をコンテキストではなくモジュール化された構造で補完する Sidecar-Extended Agent Model を提案し、その中核構成要素である Knowledge Layer の完全実装(WQS)を用いて厳格な post-cutoff 検証を行った。無料枠モデルのみで 62.5% の到達率を達成し、観測された全失敗がモデル更新を要しないレイヤー改善で説明可能であることを示した。SEAMは、LLM単体の限界を構造的に補完し、持続的に進化可能なAIエージェントを実現するアーキテクチャとして、理論的・実証的に支持される。
付録
A. 再現性: 評価スクリプトは冪等設計(完了済みIDスキップ)であり、--workers 6 --max-steps 6 で再現可能。--max-steps 10 により探索予算を拡張できる。
B. 用語: Sidecar=LLM外部の拡張モジュール。Agent=ツール選択・状態更新を担う制御主体。post-cutoff=モデル学習データの収録期限以後の事実。